
Brauchen wir wirklich für jede Entscheidung ein LLM? Jev mit Spring Boot im Test
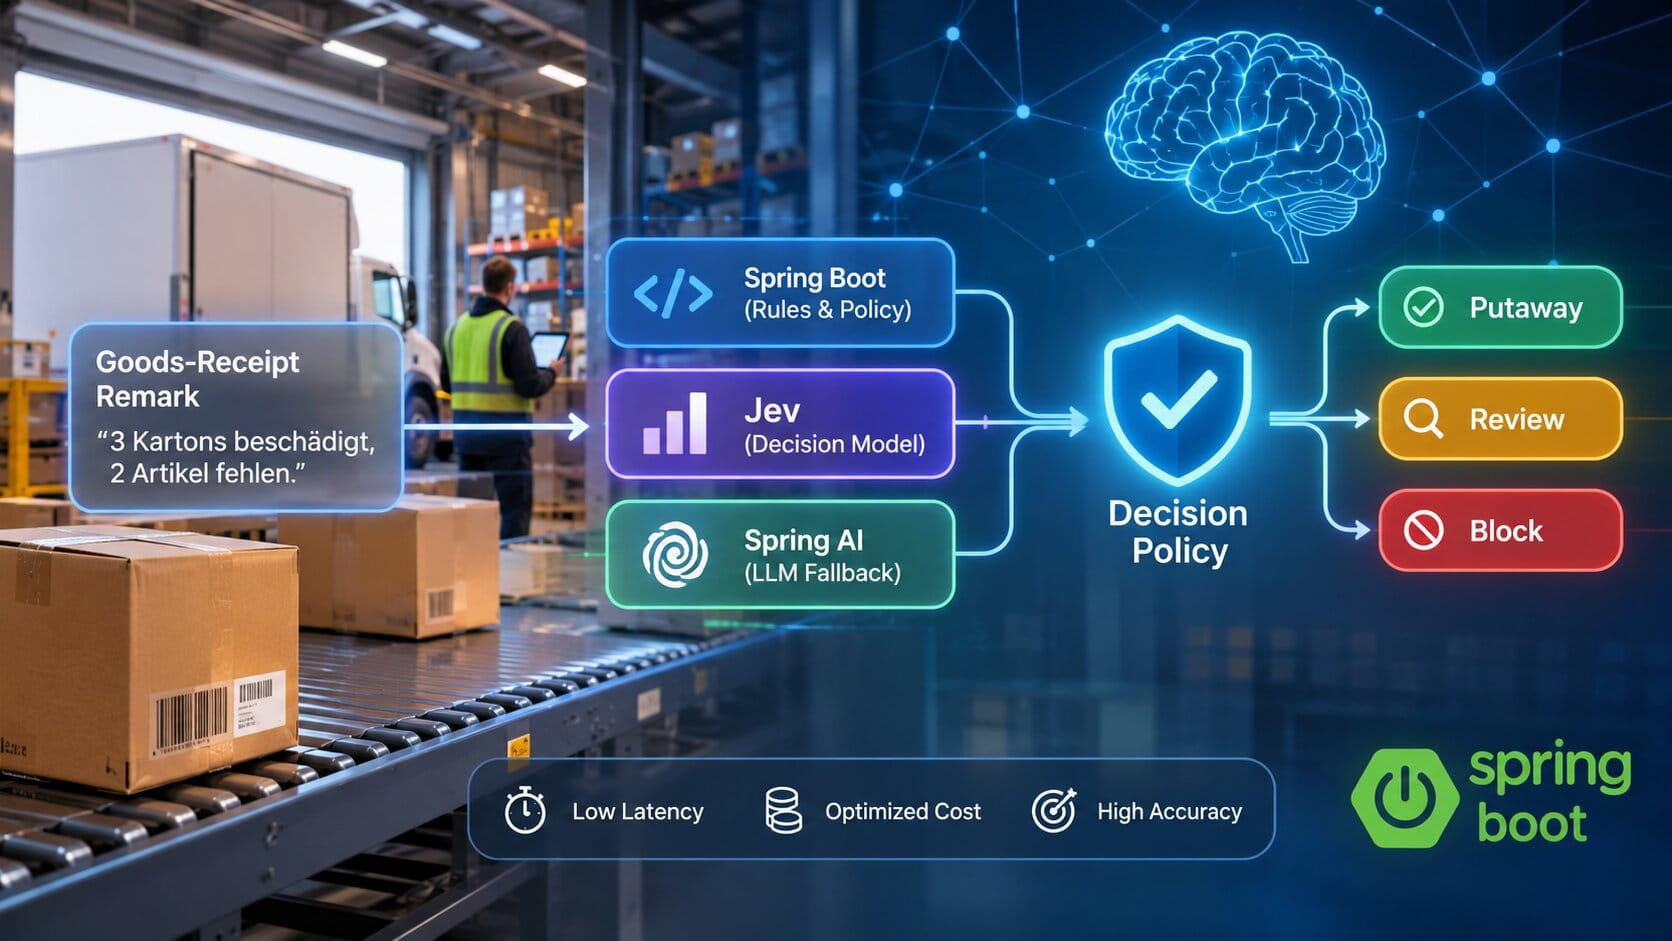
Wie viele Entscheidungen in deinem Backend brauchen eigentlich ein großes Sprachmodell? Ich habe einen Wareneingangs-Triage-Service in Spring Boot gebaut und drei Ansätze verglichen — einfache Java-Regeln, Jev (ein Decision Model von TypeSafe AI) und Claude Haiku 5.5 — anhand von 200 synthetischen Lager-Bemerkungen auf Deutsch und Englisch, jeweils drei Durchläufe. Das ist die Kurzversion; der vollständige Artikel auf Medium enthält die Architektur, den Spring-Boot-Code, die kompletten Benchmark-Tabellen und eine Produktions-Checkliste.
Was ist Jev?
Jev ist ein Decision Model, kein Textgenerator: Statt einen Satz zu schreiben, den man wieder in eine Antwort zurückparsen muss, wählt es aus vorher definierten Optionen und liefert für jede eine Wahrscheinlichkeit. Das entspricht dem, was Daniel Kahneman System-1-Denken nennt — schnelle, intuitive Urteile über eine feste Optionsmenge —, und das beschreibt überraschend viele Backend-KI-Aufgaben: Ist das Spam, welches Team bekommt dieses Ticket, ist das dringend.
Was der Benchmark zeigt
Das Kategorisieren einer Bemerkung war gelöst — Jev und Claude Haiku 5.5 erreichten beide 100 %, während Keyword-Regeln nur bei 36 % der Bemerkungen überhaupt griffen. Die schwierigere, folgenreichere Frage war, ob die Ware von der Einlagerung gesperrt werden muss: Claude lag hier bei 98 % richtig, Jev bei 72 %. Die Lösung war aber nicht der Modellwechsel. Ein umformulierter Satz in Jevs Kriterien hob die Genauigkeit auf 85 %, und eine einzige Regel aus den eigenen Stammdaten des Lagers — bei fehlenden Dokumenten nur sperren, wenn die Ware gefahrgutpflichtig ist — brachte sie auf 97 %, bei 225 ms statt 1,5 Sekunden und etwa einem Achtel der Kosten. Dieser 97-%-Wert hat einen Vorbehalt: Die umformulierten Kriterien und die Stammdaten-Regel wurden entwickelt, nachdem ich Jevs Fehler analysiert hatte — ein vielversprechendes Ergebnis also, aber noch kein unabhängig validiertes.
Wo welche Schicht wirklich hingehört
- Schnelle, geschlossene Urteile (Triage, Kategorisierung, Routing) → ein Decision Model wie Jev, kein LLM
- Risikosignale vor nicht umkehrbaren Aktionen (Lagerbuchungen, Zahlungen) → zuerst deterministische Regeln, ein Modellsignal obendrauf, nie die alleinige Instanz
- Offener Text, mehrstufiges Schlussfolgern, echte Unsicherheit → ein LLM, bewusst eingesetzt, nicht standardmäßig
- Policy-Fragen, die die eigenen Stammdaten schon beantworten → kein Modell fragen, einfach die Daten lesen
Der vollständige Artikel behandelt die Spring-Boot-Umsetzung — Jev als einfacher REST-Client, eine Routing-Policy aus Konfidenz und Risiko, ein Resilience4j-Fallback —, einen Structured-Output-Fehler bei Claude Haiku 5.5, der durch dessen eigene Reasoning-Blöcke entstand, und den vollständigen Benchmark: Kalibrierungskurven, sichere Automatisierungsquote bei einem 2-%-Fehlerbudget und die Lektionen daraus. Der vollständige Quellcode, der gelabelte Datensatz und das Analyseskript stehen auf GitHub. Weiterlesen: den vollständigen Artikel auf Medium →

Mohammed Ahmadi
Software Developer
Empfohlen
- JBang: Java als Skriptsprache
- Resilience4j in Spring Boot: Von null zu produktionsreifer Fehlertoleranz
- Eine Schritt-für-Schritt-Anleitung aus der Praxis zur Absicherung der Unternehmens-zu-Unternehmens-API-Kommunikation mit OAuth 2.0
- End-to-End-Tests mit Playwright — schnelles Setup & Best Practices
- Visualisierung von SBOMs mit dem Dependency Radar: ein praxisorientierter Ansatz für Dependency Management
- Request-Response-API-Stile: REST vs. gRPC vs. GraphQL vs. SOAP
- Ein 3D-Lager-Visualisierer mit Three.js